Linux的文件IO和多进程
Linux文件IO多进程Linux中的用户编程接口(API)遵循了UNIX中的应用编程界面标准——POSIX。这些系统调用编程接口主要是通过C库(libc)实现的。
Linux中程序的运行空间主要分为内核空间和用户空间,通常用户能直接访问的是用户空间,内核空间一般通过系统调用才能访问。
主要内容均来自于网络,仅作笔记之用,主要记录一下文件IO的一些基本API和多进程编程方式。
文件IO
文件IO中的API主要是对文件的读写操作以及属性查询。主要API包括open,read,write,close,lseek,select和属性查询的stat。
对于系统内核,所有操作的文件都是通过文件描述符引用的。文件描述符用一个非负整数表示,当程序打开或者创建文件时,内核向进程返回一个文件描述符用于继续操作;当写一个文件时,则是通过将文件描述符作为参数传递给操作文件的API用于继续处理。
在POSIX应用程序中,整数0、1、2应被代换成符号常数:
STDIN_FILENO(标准输入,默认是键盘)STDOUT_FILENO(标准输出,默认是屏幕)STDERR_FILENO(标准错误输出,默认是屏幕)
这些常数都定义在头文件<unistd.h>中,文件描述符的范围是0~OPEN_MAX。早期的UNIX版本采用的上限值是19(允许每个进程打开20个文件), 现在很多系统则将其增加至256。
可用的文件I\O函数很多,包括:打开文件,读文件,写文件等。大多数Linux文件I\O只需要用到5个函数:open,read,write,lseek以及close。
open
功能说明
需要包含的头文件: <sys/types.h>, <sys/stat.h>, <fcntl.h> 函数原型:
int open(const str * pathname, int oflag, [..., mode_t mode])该函数主要用于打开文件,打开成功返回文件描述符,失败返回-1。
参数说明
pathname: 文件的全路径名。 mode: 对于open函数而言,仅当创建文件时才使用该参数,主要用于文件权限的设置。
oflag: 表示打开的一些方式,主要有O_RDONLY(只读打开)、O_WRONLY(只写打开)、O_RDWR(读写打开)和:O_APPEND: 追加到文件尾O_CREAT: 若文件不存在则创建它。使用此选择项时,需同时说明第三个参数mode,用其说明新文件的访问权限O_EXCL: 如果同时指定O_CREAT,而该文件又是存在的,报错;也可以测试一个文件是否存在,不存在则创建。O_TRUNC: 如果此文件存在,而且为读写或只写成功打开,则将其长度截短为0O_SYNC: 使每次write都等到物理I\O操作完成
例子
创建文件:
#include <stdio.h>
#include <stdlib.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>

#define FILE_PATH   "./test.txt"

int main(void)
{
    int fd;
    if ((fd = open(FILE_PATH, O_RDWR | O_CREAT | O_EXCL, 0666)) < 0) {
        printf("open error\n");
        exit(-1);
    } else {
        printf("open success\n");
    }
    return 0;
}
read
功能说明
主要用于读取文件数据。头文件: <unistd.h> 函数原型:
ssize_t read(int fd, void * buf, size_t count)返回实际读到的字节数,读到文件尾返回0,出错返回-1。其中ssize_t是在头文件中用typedef定义的,相当于signed int类型。
参数说明
fd:要读取的文件的描述符buf:得到的数据在内存中的位置的首地址count:期望本次能读取到的最大字节数。size_t是系统头文件中用typedef定义的数据类型,相当于unsigned int
write
功能说明
和read对应,主要用于写入和修改文件。 函数原型:
ssize_t write(int fd, const void * buf, size_t count)返回实际写入的字节数,出错返回-1。
参数说明
fd:要写入文件的文件描述符 buf:要写入文件的数据在内存中存放位置的首地址 count:期望写入的数据的最大字节数
例子
读写文件:read && write
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>

int main(void)
{
    char buf[100];
    int num = 0;

    // 获取键盘输入
    if ((num = read(STDIN_FILENO, buf, 10)) == -1) {
        printf ("read error");
        error(-1);
    } else {
    // 输出到屏幕上
        write(STDOUT_FILENO, buf, num);
    }

    return 0;
}
close
功能说明
主要用于关闭文件,头文件是unistd.h。 函数原型:
int close(int filedes)参数说明
输入参数是需要关闭的文件的描述符。
当一个进程终止的时候,它所有的打开文件都是由内核自动关闭。很多程序都使用这一功能而不显式地调用close关闭一个已打开的文件。
但是,作为一名优秀的程序员,应该显式的调用close来关闭已不再使用的文件。
lseek
功能说明
主要用来设置文件内容的读写位置,是用的较多的操作。需要包含头文件unistd.h和sys/types.h
每个打开的文件都有一个“当前文件偏移量”,是一个非负整数,用以度量从文件开始处计算的字节数。通常,读写操作都是从当前文件偏移量处开始,并使偏移量增加所读或写的字节数。默认情况下,你打开一个文件时(
open),除非指定O_APPEND参数,不然位移量被设为0。
函数原型:
off_t lseek(int filesdes, off_t offset, int whence)参数说明
返回新的文件位移,出错返回-1。同样off_t是系统头文件定义的数据类型,相当于signed int。
whence是
SEEK_SET, 那么该文件的位移量设置为据文件开始处offset个字节 whence是SEEK_CUR, 那么该文件的位移量设置为当前值加offset。offset可为正或负 whence是SEEK_END, 那么该文件的位移量设置为文件长度加offset。offset可为正或负
例子
#include <stdio.h>
#include <stdlib.h>
#include <sys/types.h>
#include <unistd.h>
#include <fcntl.h>

int main(int argc, char * argv[])
{
    int fd;
    char buf[100];
    if ((fd = open(argv[1], O_RDONLY)) < 0) {
        perror("open");
        exit(-1);
    }
    read(fd, buf, 1);
    write(STDOUT_FILENO, buf, 1);
    lseek(fd, 2, SEEK_CUR);

    read(fd, buf, 1);
    write(STDOUT_FILENO, buf, 1);
    lseek(fd, -1, SEEK_END);

    read(fd, buf, 1);
    write(STDOUT_FILENO, buf, 1);
    lseek(fd, 0, SEEK_SET);

    read(fd, buf, 1);
    write(STDOUT_FILENO, buf, 1);
    close(fd);
    printf("\n");

    return 0;
}
select
功能说明
用于同时监控多个文件描述符。因为read一次只能监控一个,且在监控过程中处于阻塞状态,无法同时监控多个输入。需要包含头文件sys/select.h。
函数原型:
int select(int maxfd, fd_set \* readset, fd_set \* writeset, fd_set \* exceptset, const struct timeval \* timeout)参数说明
返回值:失败返回-1,成功返回readset,writeset,exceptset中所有,有指定变化的文件描述符的数目(若超时返回0)
maxfd:要检测的描述符个数, 因此值应为最大描述符+1readset:被监控是否有输入的文件描述符集。不监控时,设为NULLwriteset:被监控是否可以输入的文件描述符集。不监控时,设为NULLexceptset:被监控是否有错误产生的文件描述符集。不监控时,设为NULLtimeval:监控超时时间。设置为NULL表示一直阻塞到有文件描述符被监控到有指定变化。
Tips:
readset,writeset,exceptset这三个描述符集指针均是值—结果参数,调用的时候,被监控描述符相应位需要置1;返回时,未就绪的描数字相应位会被清0,而就绪的会被置1。 下面的系统定义的宏,和select配套使用FD_ZERO(&rset):将文件描述符集rset的所有位清0FD_SET(4, &reset):设置文件描述符集rset的bit 4FD_CLR(fileno(stdin), &rset):将文件描述符集rset的bit 0清0FD_ISSET(socketfd, &rset):若文件描述符集rset中的socketfd位置1
例子
#include <stdio.h>
#include <sys/select.h>
#include <fcntl.h>
#include <unistd.h>

#define MAXNUM      100
#define OPEN_DEV    "/dev/input/mice"

int main(void)
{
    fd_set rfds;
    struct timeval tv;
    int retval, fd;
    char buf[MAXNUM];

    fd = open(OPEN_DEV, O_RDONLY);
    while (1) {
        FD_ZERO(&rfds);
        FD_SET(0, &rfds);
        FD_SET(fd, &rfds);
        tv.tv_sec = 5;
        tv.tv_usec = 0;

        retval = select(fd+1, &rfds, NULL, NULL, &tv);
        if (retval < 0)
            printf ("error\n");
        if (retval == 0)
            printf ("No data within 5 seconds\n");
        if (retval > 0) {
            if (FD_ISSET(0, &rfds)) {
                printf ("Data is available from keyboard now\n");
                read(0, buf, MAXNUM);
            }
            if (FD_ISSET(fd, &rfds)) {
                printf ("Data is available from mouse now\n");
                read(fd, buf, MAXNUM);
            }
        }
    }
    return 0;
}
stat
基本用法
主要功能是获取文件的属性。需要包含头文件<sys/types.h>,<sys/stat.h>,<unistd.h>。 函数原型:
int stat(const char \* path, struct stat \* buf)参数说明
path:要查看属性的文件或目录的全路径名称。
buf:指向用于存放属性的结构体。stat成功调用后,buf的各个字段将存放各个属性。struct stat是系统头文件中定义的结构体,定义如下:
struct stat {
    dev_t       st_dev;
    ino_t       st_ino;
    mode_t      st_mode;
    nlink_t     st_nlink;
    uid_t       st_uid;
    gid_t       st_gid;
    dev_t       st_rdev;
    off_t       st_size;
    blksize_t   st_blksize;
    blkcnt_t    st_blocks;
    time_t      st_atime;
    time_t      st_mtime;
    time_t      st_ctime;
};
st_ino:节点号st_mode:文件类型和文件访问权限被编码在该字段中st_nlink:硬连接数st_uid:属主的用户IDst_gid:所属组的组IDst_rdev:设备文件的主、次设备号编码在该字段中st_size:文件的大小st_mtime:文件最后被修改时间 成功返回0,失败返回-1。
例子
#include <stdio.h>
#include <stdlib.h>
#include <sys/stat.h>
#include <sys/types.h>
#include <unistd.h>

int main(int argc, char **argv)
{
    struct stat     buf;
    if(argc != 2) {
        printf("Usage: stat <pathname>");
        exit(-1);
    }
    if(stat(argv[1], &buf) != 0) {
        printf("stat error.");
        exit(-1);
    }
    printf("#i-node:    %ld\n", buf.st_ino);
    printf("#link:      %d\n", buf.st_nlink);
    printf("UID:        %d\n", buf.st_uid);
    printf("GID:        %d\n", buf.st_gid);
    printf("Size        %ld\n", buf.st_size);
    exit(0);
}
文件类型的判定
struct stat中有个字段为st_mode,可用来获取文件类型和文件访问权限,可以从该字段解码我们需要的文件信息。
st_mode中文件类型宏定义:S_ISREG(): 普通文件S_ISDIR(): 目录文件S_ISCHR(): 字符设备文件S_ISBLK(): 块设备文件S_ISFIFO(): 有名管道文件S_ISLNK(): 软连接(符号链接)文件S_ISSOCK(): 套接字文件
例子
#include <stdlib.h>
#include <sys/stat.h>
#include <sys/types.h>
#include <unistd.h>

int main(int argc, char **argv)
{
    struct stat buf;
    char * file_mode;
    if(argc != 2) {
        printf("Usage: stat <pathname>\n");
        exit(-1);
    }
    if(stat(argv[1], &buf) != 0) {
        printf("stat error.\n");
        exit(-1);
    }
    if (S_ISREG(buf.st_mode))
        file_mode = "-";
    else if (S_ISDIR(buf.st_mode))
        file_mode = "d";
    else if (S_ISCHR(buf.st_mode))
        file_mode = "c";
    else if(S_ISBLK(buf.st_mode))
        file_mode = "b";
    printf("#i-node:    %ld\n", buf.st_ino);
    printf("#link:      %d\n", buf.st_nlink);
    printf("UID:        %d\n", buf.st_uid);
    printf("GID:        %d\n", buf.st_gid);
    printf("Size        %ld\n", buf.st_size);
    printf("mode: %s\n", file_mode);
    exit(0);
}
文件权限的判定
文件类型与许可设定被一起编码在st_mode字段中,也需要一组由系统提供的宏来完成解码。
S_ISUID: 执行时,设置用户IDS_ISGID: 执行时,设置组IDS_ISVTX: 保存正文S_IRWXU: 拥有者的读、写和执行权限S_IRUSR: 拥有者的读权限S_IWUSR: 拥有者的写权限S_IXUSR: 拥有者的执行权限S_IRWXG: 用户组的读、写和执行权限S_IRGRP: 用户组的读权限S_IWGRP: 用户组的写权限S_IXGRP: 用户组的执行权限S_IRWXO: 其它读、写、执行权限S_IROTH: 其它读权限S_IWOTH: 其它写权限S_IXOTH: 其它执行权限
stat的目录操作
打开目录
需要包含的头文件:
<sys/types.h>,<dirent.h>函数原型:DIR * opendir(const char * name)功能:opendir()用来打开参数name指定的目录,并返回DIR *形态的目录流 返回值:成功返回目录流;失败返回NULL
读取目录
函数原型:
struct dirent * readdir(DIR * dir)功能:readdir()返回参数dir目录流的下一个子条目(子目录或子文件) 返回值: 成功返回结构体指向的指针,错误或已读完目录,返回NULL 函数执行成功返回的结构体原型如下:
struct dirent {
   ino_t   d_ino;
   off_t   d_off;
   unsigned short  d_reclen;
   unsigned char   d_type;
   char    d_name[256];
};
其中 d_name字段,是存放子条目的名称
关闭目录
函数原型:
int closedir(DIR * dir)功能:closedir()关闭dir所指的目录流 返回值:成功返回0;失败返回-1,错误原因在errno中 例子:
#include <stdio.h>
#include <stdlib.h>
#include <dirent.h>
int main(int argc, char *argv[])
{
    DIR *dp;
    struct dirent *entp;
    if (argc != 2) {
        printf("usage: showdir dirname\n");
        exit(0);
    }
    if ((dp = opendir(argv[1])) == NULL) {
        perror("opendir");
        exit(-1);
    }
    while ((entp = readdir(dp)) != NULL)
        printf("%s\n", entp->d_name);

    closedir(dp);
    return 0;
}
多进程
Linux的基本进程状态
其实在使用top命令时候也可以看到一些标识,如R/S/D/T/Z/X等。
R (TASK_RUNNING),可执行状态。 只有在该状态的进程才可能在CPU上运行。而同一时刻可能有多个进程处于可执行状态,这些进程的task_struct结构(进程控制块)被放入对应CPU的可执行队列中(一个进程最多只能出现在一个CPU的可执行队列中)。进程调度器的任务就是从各个CPU的可执行队列中分别选择一个进程在该CPU上运行。 很多操作系统教科书将正在CPU上执行的进程定义为RUNNING状态、而将可执行但是尚未被调度执行的进程定义为READY状态,这两种状态在linux下统一为TASK_RUNNING状态。S (TASK_INTERRUPTIBLE),可中断的睡眠状态。 处于这个状态的进程因为等待某某事件的发生(比如等待socket连接、等待信号量),而被挂起。这些进程的task_struct结构被放入对应事件的等待队列中。当这些事件发生时(由外部中断触发、或由其他进程触发),对应的等待队列中的一个或多个进程将被唤醒。 通过ps命令我们会看到,一般情况下,进程列表中的绝大多数进程都处于TASK_INTERRUPTIBLE状态(除非机器的负载很高)。毕竟CPU就这么一两个,进程动辄几十上百个,如果不是绝大多数进程都在睡眠,CPU又怎么响应得过来。D (TASK_UNINTERRUPTIBLE),不可中断的睡眠状态。 与TASK_INTERRUPTIBLE状态类似,进程处于睡眠状态,但是此刻进程是不可中断的。不可中断,指的并不是CPU不响应外部硬件的中断,而是指进程不响应异步信号。 绝大多数情况下,进程处在睡眠状态时,总是应该能够响应异步信号的。否则你将惊奇的发现,kill -9竟然杀不死一个正在睡眠的进程了!于是我们也很好理解,为什么ps命令看到的进程几乎不会出现TASK_UNINTERRUPTIBLE状态,而总是TASK_INTERRUPTIBLEi状态。 而TASK_UNINTERRUPTIBLE状态存在的意义就在于,内核的某些处理流程是不能被打断的。如果响应异步信号,程序的执行流程中就会被插入一段用于处理异步信号的流程(这个插入的流程可能只存在于内核态,也可能延伸到用户态),于是原有的流程就被中断了。(参见《linux内核异步中断浅析》) 在进程对某些硬件进行操作时(比如进程调用read系统调用对某个设备文件进行读操作,而read系统调用最终执行到对应设备驱动的代码,并与对应的物理设备进行交互),可能需要使用TASK_UNINTERRUPTIBLE状态对进程进行保护,以避免进程与设备交互的过程被打断,造成设备陷入不可控的状态。这种情况下的TASK_UNINTERRUPTIBLE状态总是非常短暂的,通过ps命令基本上不可能捕捉到。 linux系统中也存在容易捕捉的TASK_UNINTERRUPTIBLE状态。执行vfork系统调用后,父进程将进入TASK_UNINTERRUPTIBLE状态,直到子进程调用exit或exec(参见《神奇的vfork》)。 通过下面的代码就能得到处于TASK_UNINTERRUPTIBLE状态的进程:
ps -ax | grep a\.out
4371 pts/0    D+     0:00 ./a.out
4372 pts/0    S+     0:00 ./a.out
4374 pts/1    S+     0:00 grep a.out
然后我们可以试验一下
TASK_UNINTERRUPTIBLE状态的威力。不管kill还是kill -9,这个TASK_UNINTERRUPTIBLE状态的父进程依然屹立不倒。T (TASK_STOPPED or TASK_TRACED),暂停状态或跟踪状态。 向进程发送一个SIGSTOP信号,它就会因响应该信号而进入TASK_STOPPED状态(除非该进程本身处于TASK_UNINTERRUPTIBLE状态而不响应信号)。(SIGSTOP与SIGKILL信号一样,是非常强制的。不允许用户进程通过signal系列的系统调用重新设置对应的信号处理函数。) 向进程发送一个SIGCONT信号,可以让其从TASK_STOPPED状态恢复到TASK_RUNNING状态。 当进程正在被跟踪时,它处于TASK_TRACED这个特殊的状态。“正在被跟踪”指的是进程暂停下来,等待跟踪它的进程对它进行操作。比如在gdb中对被跟踪的进程下一个断点,进程在断点处停下来的时候就处于TASK_TRACED状态。而在其他时候,被跟踪的进程还是处于前面提到的那些状态。 对于进程本身来说,TASK_STOPPED和TASK_TRACED状态很类似,都是表示进程暂停下来。 而TASK_TRACED状态相当于在TASK_STOPPED之上多了一层保护,处于TASK_TRACED状态的进程不能响应SIGCONT信号而被唤醒。只能等到调试进程通过ptrace系统调用执行PTRACE_CONT、PTRACE_DETACH等操作(通过ptrace系统调用的参数指定操作),或调试进程退出,被调试的进程才能恢复TASK_RUNNING状态。Z (TASK_DEAD – EXIT_ZOMBIE),退出状态,进程成为僵尸进程。进程在退出的过程中,处于
TASK_DEAD状态。在这个退出过程中,进程占有的所有资源将被回收,除了
task_struct结构(以及少数资源)以外。于是进程就只剩下task_struct这么个空壳,故称为僵尸。之所以保留
task_struct,是因为task_struct里面保存了进程的退出码、以及一些统计信息。而其父进程很可能会关心这些信息。比如在shell中,$?变量就保存了最后一个退出的前台进程的退出码,而这个退出码往往被作为if语句的判断条件。当然,内核也可以将这些信息保存在别的地方,而将
task_struct结构释放掉,以节省一些空间。但是使用task_struct结构更为方便,因为在内核中已经建立了从pid到task_struct查找关系,还有进程间的父子关系。释放掉task_struct,则需要建立一些新的数据结构,以便让父进程找到它的子进程的退出信息。 父进程可以通过wait系列的系统调用(如wait4、waitid)来等待某个或某些子进程的退出,并获取它的退出信息。然后wait系列的系统调用会顺便将子进程的尸体(task_struct)也释放掉。 子进程在退出的过程中,内核会给其父进程发送一个信号,通知父进程来“收尸”。这个信号默认是SIGCHLD,但是在通过clone系统调用创建子进程时,可以设置这个信号。
ps -ax | grep a\.out
10410 pts/0    S+     0:00 ./a.out
10411 pts/0    Z+     0:00 [a.out]
0413 pts/1    S+     0:00 grep a.out
只要父进程不退出,这个僵尸状态的子进程就一直存在。那么如果父进程退出了呢,谁又来给子进程“收尸”? 当进程退出的时候,会将它的所有子进程都托管给别的进程(使之成为别的进程的子进程)。托管给谁呢?可能是退出进程所在进程组的下一个进程(如果存在的话),或者是1号进程。所以每个进程、每时每刻都有父进程存在。除非它是1号进程。 1号进程,pid为1的进程,又称init进程。 linux系统启动后,第一个被创建的用户态进程就是init进程。它有两项使命: 1、执行系统初始化脚本,创建一系列的进程(它们都是init进程的子孙); 2、在一个死循环中等待其子进程的退出事件,并调用waitid系统调用来完成“收尸”工作; init进程不会被暂停、也不会被杀死(这是由内核来保证的)。它在等待子进程退出的过程中处于
TASK_INTERRUPTIBLE状态,“收尸”过程中则处于TASK_RUNNING状态。 X (TASK_DEAD – EXIT_DEAD),退出状态,进程即将被销毁。 而进程在退出过程中也可能不会保留它的task_struct。比如这个进程是多线程程序中被detach过的进程(进程、线程参见《linux线程浅析》)。或者父进程通过设置SIGCHLD信号的handler为SIG_IGN,显式的忽略了SIGCHLD信号。(这是posix的规定,尽管子进程的退出信号可以被设置为SIGCHLD以外的其他信号。) 此时,进程将被置于EXIT_DEAD退出状态,这意味着接下来的代码立即就会将该进程彻底释放。所以EXIT_DEAD状态是非常短暂的,几乎不可能通过ps命令捕捉到。
获取进程标识号
主要有两个函数:getpid和getppid。 前者是获取进程号,后者是获取父进程号。 需要包含的头文件:<sys/types.h>, <unistd.h>
函数原型:
pid_t getpid(void)功能:获取当前进程ID 返回值:调用进程的进程ID 函数原型:pid_t getppid(void)功能:获取父进程ID 返回值:调用进程的父进程ID 例子:
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>

int main(void)
{
    pid_t pid = getpid();
    pid_t ppid = getppid();

    printf ("pid = %d\n", pid);
    printf ("ppid = %d\n", ppid);

    return 0;
}
Linux下C进程内存布局
C进程内存布局说明
text:代码段。存放的是程序的全部代码(指令),来源于二进制可执行文件中的代码部分 initialized data(简称data段)和uninitialized data(简称bss段)组成了数据段。
其中data段存放的是已初始化全局变量和已初始化static局部变量,来源于二进制可执行文件中的数据部分;bss段存放的是未初始化全局变量和未初始化static局部变量,其内容不来源于二进制可执行文件中的数据部分(也就是说:二进制可执行文件中的数据部分没有未初始化全局变量和未初始化static局部变量)。根据C语言标准规定,他们的初始值必须为0,因此bss段存放的是全0。将bss段清0的工作是由系统在加载二进制文件后,开始执行程序前完成的,系统执行这个清0操作是由内核的一段代码完成的,这段代码就是即将介绍的exec系统调用。至于exec从内存什么地方开始清0以及要清0多少空间,则是由记录在二进制可执行文件中的信息决定的(即:二进制文件中记录了text、data、bss段的大小) malloc是从heap(堆)中分配空间的 stack(栈)存放的是动态局部变量。 当子函数被调用时,系统会从栈中分配空间给该子函数的动态局部变量(注意:此时栈向内存低地址延伸);当子函数返回时,系统的栈会向内存高地址延伸,这相当于释放子函数的动态局部变量的内存空间。我们假设一下,main函数在调用子函数A后立即调用子函数B,那么子函数B的动态局部变量会覆盖原来子函数A的动态局部变量的存储空间,这就是子函数不能互相访问对方动态局部变量的根本物理原因。 内存的最高端存放的是命令行参数和环境变量,将命令行参数和环境变量放到指定位置这个操作是由OS的一段代码(exec系统调用)在加载二进制文件到内存后,开始运行程序前完成的。 Linux下C进程内存布局可以由下面的程序的运行结果来获得验证:
 #include <stdio.h>
 #include <stdlib.h>

 int global_init_val = 100;
 int global_noninit_val;
 extern char **environ;

 int main(int argc, char *argv[], char *envp[])
 {
         static int localstaticval = 10;
         char *localval;
         localval = malloc(10);
         printf("address of text  is : %p\n", main);
         printf("address of data  is : %p, %p\n", &global_init_val, &localstaticval);
         printf("address of bss   is : %p\n", &global_noninit_val);
         printf("address of heap  is : %p\n", localval);
         printf("address of stack is : %p\n", &localval);
         free(localval);

         printf("&environ = %p, environ = %p\n", &envp, envp);
         printf("&argv = %p, argv = %p\n", &argv, argv);
         return 0;
  }
运行结果,如下:
1 address of text  is : 0x8048454
2 address of data  is : 0x804a01c, 0x804a020
3 address of bss   is : 0x804a02c
4 address of heap  is : 0x96e1008
5 address of stack is : 0xbffca8bc
6 &environ = 0xbffca8d8, environ = 0xbffca97c
7 &argv = 0xbffca8d4, argv = 0xbffca974
运行结果的第1(2、3、4、5、6、7)行是由程序的第13(14、15、16、17、20、21)行打印的。 由运行结果的第1、2、3、4行可知,存放的是程序代码的text段位于进程地址空间的最低端;往上是存放已初始化全局变量和已初始化static局部变量的data段;往上是存放未初始化全局变量的bss段;往上是堆区(heap)。 由运行结果的第7、6、5行可知,命令行参数和环境变量存放在进程地址空间的最高端;往下是存放动态局部变量的栈区(stack)。
环境变量的获取与设置
坏境变量在内存中通常是一字符串环境变量名=环境变量值的形式存放。我们的程序可能会调用Linux系统的环境变量,甚至修改环境变量,所以,Linux向我们提供了这种API。需要包含头文件<stdlib.h>。 函数原型: char * getenv(const char * name) 返回字符指针,该指针指向变量名为name的环境变量的值字符串。 int putenv(const char * str) 将“环境变量=环境变量值”形式的字符创增加到环境变量列表中;如果该环境变量已存在,则更新已有的值。 int setenv(const char * name, const char * value, int rewrite) 设置名字为name的环境变量的值为value;如果该环境变量已存在,且rewrite不为0,用新值替换旧值;rewrite为0,就不做任何事。 例子:
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>

int main(int argc, char *argv[], char *envp[])
{
        char **ptr;
        for (ptr = envp; *ptr != 0; ptr++)   /* and all env strings */
                printf ("%s\n", *ptr);

        printf ("\n\n--------My environment variable-------\n\n");
        printf ("USERNAME is %s\n", getenv("USERNAME"));
        putenv ("USERNAME=shiyanlou");

        printf ("USERNAME is %s\n", getenv("USERNAME"));
        setenv ("USERNAME", "shiyanlou-2", 0);

        printf ("USERNAME is %s\n", getenv("USERNAME"));
        setenv ("USERNAME", "shiyanlou-2", 1);

        printf ("USERNAME is %s\n", getenv("USERNAME"));

        return 0;
}
fork进程控制
fork被称为进程控制天字第1号系统调用,可以看出其使用广泛性。
fork的机制与特性
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>

int main(void)
{
    pid_t pid;
    if ((pid = fork()) == 0) {
        getchar();
        exit(0);
    }
    getchar();
}
父进程调用fork将会产生一个子进程。此时会有2个问题:
- 子进程的代码从哪里来?
- 子进程首次被OS调度时,执行的第1条代码是哪条代码?
子进程的代码是父进程代码的一个完全相同拷贝。事实上不仅仅是text段,子进程的全部进程空间(包括:text/data/bss/heap/stack/command line/environment variables)都是父进程空间的一个完全拷贝。 下一个问题是:谁为子进程分配了内存空间?谁拷贝了父进程空间的内容到子进程的内存空间?fork当仁不让!事实上,查看fork实现的源代码,由4部分工作组成:首先,为子进程分配内存空间;然后,将父进程空间的全部内容拷贝到分配给子进程的内存空间;然后在内核数据结构中创建并正确初始化子进程的PCB(包括2个重要信息:子进程pid,PC的值=善后代码的第1条指令地址);最后是一段善后代码。 由于子进程的PCB已经产生,所以子进程已经出生,因此子进程就可以被OS调度到来运行。子进程首次被OS调度时,执行的第1条代码在fork内部,不过从应用程序的角度来看,子进程首次被OS调度时,执行的第1条代码是从fork返回。这就导致了fork被调用1次,却返回2次:父、子进程中各返回1次。对于应用程序员而言,最重要的是fork的2次返回值不一样,父进程返回值是子进程的pid,子进程的返回值是0。 至于子进程产生后,父、子进程谁先运行,取决于OS调度策略,应用程序员无法控制。 以上分析了fork的内部实现以及对应用程序的影响。如果应用程序员觉得难以理解的话,可以暂时抛开,只要记住3个结论即可: fork函数被调用1次(在父进程中被调用),但返回2次(父、子进程中各返回一次)。两次返回的区别是子进程的返回值是0,而父进程的返回值则是子进程的进程ID。 父、子进程完全一样(代码、数据),子进程从fork内部开始执行;父、子进程从fork返回后,接着执行下一条语句。 一般来说,在fork之后是父进程先执行还是子进程先执行是不确定的,应用程序员无法控制。
fork实例分析
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/types.h>

#define err_sys(info)    \
   {                      \
        printf ("%s\n", info);\
        exit(0); \
   }

int glob = 6;  /* external variable in initialized data */
char buf[ ] = "a write to stdout\n";

int main(void)
{
    int var;  /* automatic variable on the stack */
    pid_t pid;
    var = 88;

    if ((write(STDOUT_FILENO, buf, sizeof(buf)-1) != sizeof(buf)-1))
        err_sys("write error");

    printf("before fork\n");  /* we don't flush stdout */

    if ( (pid = fork()) < 0) {
        err_sys("fork error");
    } else if (pid == 0) {   /* child */
       glob++;      /* modify variables */
       var++;
    } else {
        sleep(2);   /* parent */
    }

    printf("pid = %d, ppid = %d, glob = %d, var = %d\n", getpid(),getppid(), glob, var);
    exit(0);
 }
运行结果:
a write to stdout
before fork
pid = 9009, ppid = 9008, glob = 7, var = 89
pid = 9008, ppid = 8979, glob = 6, var = 88
运行结果分析: 结果的第1行是由父进程的21行打印; 结果的第2行是由父进程的24行打印; 由于父进程在24行睡眠了2秒,因此fork返回后,子进程先于父进程运行是大概率事件,所以子进程运行到25行打印出结果中的第3行。由于子进程会拷贝父进程的整个进程空间(这其中包括数据),因此当子进程26行从fork返回后,子进程中的glob=6,var=88(拷贝自父进程的数据)。此时子进程中pid=0,因此子进程会执行29、30行,当子进程到达35行时,将打印glob=7,var=89。 虽然,子进程改变了glob和var的值,但它仅仅是改变了子进程中的glob和var,而影响不了父进程中的glob和var。在子进程出生后,父、子进程的进程空间(代码、数据等)就是独立,互不干扰的。因此当父进程运行到35行,将会打印父进程中的glob和var的值,他们分别是6和88,这就是运行结果的第4行。
exec进程控制
与fork相对应,exec被成为进程控制的地字一号系统调用。
文件描述符详解
文件描述符本质是数组下表,如下图所示:
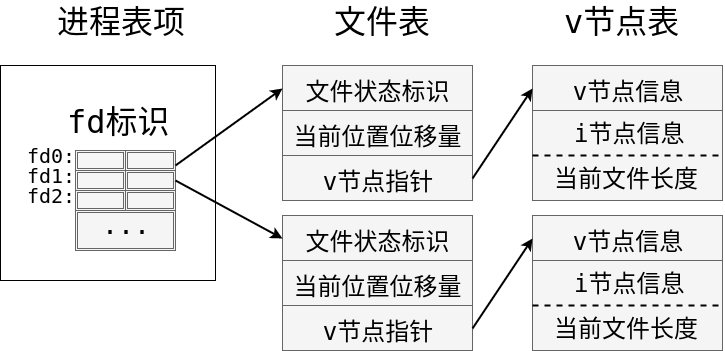
右侧的表称为i节点表,在整个系统中只有1张。该表可以视为结构体数组,该数组的一个元素对应于一个物理文件。 中间的表称为文件表,在整个系统中只有1张。该表可以视为结构体数组,一个结构体中有很多字段,其中有3个字段比较重要:
file status flags:用于记录文件被打开来读的,还是写的。其实记录的就是open调用中用户指定的第2个参数 current file offset:用于记录文件的当前读写位置(指针)。正是由于此字段的存在,使得一个文件被打开并读取后,下一次读取将从上一次读取的字符后开始读取 v-node ptr:该字段是指针,指向右侧表的一个元素,从而关联了物理文件。 左侧的表称为文件描述符表,每个进程有且仅有1张。该表可以视为指针数组,数组的元素指向文件表的一个元素。最重要的是:数组元素的下标就是大名鼎鼎的文件描述符。 open系统调用执行的操作:新建一个i节点表元素,让其对应打开的物理文件(如果对应于该物理文件的i节点元素已经建立,就不做任何操作);新建一个文件表的元素,根据open的第2个参数设置file status flags字段,将current file offset字段置0,将v-node ptr指向刚建立的i节点表元素;在文件描述符表中,寻找1个尚未使用的元素,在该元素中填入一个指针值,让其指向刚建立的文件表元素。最重要的是:将该元素的下标作为open的返回值返回。 这样一来,当调用read(write)时,根据传入的文件描述符,OS就可以找到对应的文件描述符表元素,进而找到文件表的元素,进而找到i节点表元素,从而完成对物理文件的读写。
fork对文件描述符的影响
fork会导致子进程继承父进程打开的文件描述符,其本质是将父进程的整个文件描述符表复制一份,放到子进程的PCB中。因此父、子进程中相同文件描述符(文件描述符为整数)指向的是同一个文件表元素,所以父(子)进程读取文件后,子(父)进程将读取同一文件的后续内容。
#include <stdio.h>
#include <stdlib.h>
#include <fcntl.h>
#include <sys/types.h>
#include <unistd.h>
#include <sys/types.h>

int main(void)
{
        int fd, pid, status;
        char buf[10];
        if ((fd = open("./test.txt", O_RDONLY)) < 0) {
                perror("open");  exit(-1);
        }
        if ((pid = fork()) < 0) {
                perror("fork");  exit(-1);
        } else if (pid == 0) {  //child
                read(fd, buf, 2);
                write(STDOUT_FILENO, buf, 2);
        } else {  //parent
                sleep(2);
                lseek(fd, 1, SEEK_CUR);
                read(fd, buf, 3);
                write(STDOUT_FILENO, buf, 3);
                write(STDOUT_FILENO, "\n", 1);
        }
        return 0;
}
假设,./test.txt的内容是abcdefg。那么子进程的18行将读到字符ab;由于,父、子进程的文件描述符fd都指向同一个文件表元素,因此当父进程执行23行时,fd对应的文件的读写指针将移动到字符d,而不是字符b,从而24行读到的是字符def,而不是字符bcd。程序运行的最终结果是打印abdef,而不是abbcd。 相对应的,如果是两个进程独立调用open去打开同一个物理文件,就会有2个文件表元素被创建,并且他们都指向同一个i节点表元素。两个文件表元素都有自己独立的current file offset字段,这将导致2个进程独立的对同一个物理文件进行读写,因此第1个进程读取到文件的第1个字符后,第2个进程再去读取该文件时,仍然是读到的是文件的第1个字符,而不是第1个字符的后续字符。 对应用程序员而言,最重要结论是: 如果子进程不打算使用父进程打开的文件,那么应该在fork返回后立即调用close关闭该文件。
wait同步
wait作用
在forkbase.c中,fork出子进程后,为了保证子进程先于父进程运行,在父进程中使用了sleep(2)的方式让父进程睡眠2秒。但实际上这样做,并不能100%保证子进程先于父进程运行,因为在负荷非常重的系统中,有可能在父进程睡眠2秒期间,OS并没有调度到子进程运行,并且当父进程睡醒后,首先调度到父进程运行。系统调用wait可以100%保证父、子进程完全按程序员的安排来进行同步。 需要包含的头文件: wait.h 函数原型:pid_t wait(int * status) 功能:等待进程结束。 返回值:若成功则为子进程ID号,若出错则为-1。 参数说明:
status:用于存放进程结束状态。 wait函数用于使父进程阻塞,直到一个子进程结束。父进程调用wait,该父进程可能会:
阻塞(如果其所有子进程都还在运行)。 带子进程的终止状态立即返回(如果一个子进程已终止,正等待父进程存取其终止状态)。 出错立即返回(如果它没有任何子进程)。
wait调用
#include <stdio.h>
#include <stdlib.h>
#include <sys/types.h>
#include <unistd.h>
#include <wait.h>
void pr_exit(intstatus);
int main(void)
{
        pid_t pid;
        int  status;
        if ( (pid = fork()) < 0)
            { perror("fork");exit(-1); }
        else if (pid == 0) {            /* child */
            sleep(1);
            printf("inchild\n");
            exit(101);
        }
        if (wait(&status) != pid)    /* wait for child */
            { perror("wait");exit(-2); }
        printf("in parent\n");
        pr_exit(status);               /* and print itsstatus */
        if ( (pid = fork()) < 0)
            { perror("fork");exit(-1); }
        else if (pid == 0)              /*child */
            abort();                    /* generates SIGABRT */
        if (wait(&status) != pid)               /* wait for child */
            { perror("wait");exit(-2); }
        pr_exit(status);                      /* and printits status */
        if ( (pid = fork()) < 0)
            { perror("fork");exit(-1); }
        else if (pid == 0)              /*child */
            status /= 0;            /* divide by 0 generates SIGFPE */
        if (wait(&status) != pid)               /* wait for child */
            { perror("wait");exit(-1); }
        pr_exit(status);       /* and printits status */
        exit(0);
 }
 void pr_exit(int status) {
        if (WIFEXITED(status))
            printf("normallytermination, low-order 8 bit of exit status = %d\n", WEXITSTATUS(status));
        else if(WIFSIGNALED(status))
            printf("abnormallytermination, singal number = %d\n", WTERMSIG(status));
 }
其中,11行创建了一个子进程,13行根据fork的返回值区分父、子进程。
我们先看父进程,父进程从18行运行,这里调用了wait函数等待子进程结束,并将子进程结束的状态保存在status中。这时,父进程就阻塞在wait这里了,这样就保证了子进程先运行。子进程从13行开始运行,然后sleep 1秒,打印出“in child”后,调用exit函数退出进程。这里exit中有个参数101,表示退出的值是101。.子进程退出后,父进程wait到了子进程的状态,并把状态保存到了status中。后面的pr_exit函数是用来对进程的退出状态进行打印。接下来,父进程又创建一个子进程,然后又一次调用wait函数等待子进程结束,父进程这时候阻塞在了wait这里。子进程开始执行,子进程里面只有一句话:abort(),abort会结束子进程并发送一个SIGABORT信号,唤醒父进程。所以父进程会接受到一个SIGABRT信号,并将子进程的退出状态保存到status中。然后调用pr_exit函数打印出子进程结束的状态。然后父进程再次创建了一个子进程,依然用wait函数等待子进程结束并获取子进程退出时的状态。子进程里面就一句status/= 0,这里用0做了除数,所以子进程会终止,并发送一个SIGFPE信号,这个信号是用来表示浮点运算异常,比如运算溢出,除数不能为0等。这时候父进程wait函数会捕捉到子进程的退出状态,然后调用pr_exit处理。
pr_exit函数将status状态传入,然后判断该状态是不是正常退出,如果是正常退出会打印出退出值;不是正常退出会打印出退出时的异常信号。这里用到了几个宏,简单解释如下:
WIFEXITED: 这个宏是用来判断子进程的返回状态是不是为正常,如果是正常退出,这个宏返回真。WEXITSTATUS: 用来返回子进程正常退出的状态值。WIFSIGNALED: 用来判断子进程的退出状态是否是非正常退出,若非正常退出时发送信号,则该宏返回真。WTERMSIG: 用来返回非正常退出状态的信号number。 所以这段代码的结果是分别打印出了三个子进程的退出状态和异常结束的信号编号
exec详解
当一个程序调用fork产生子进程,通常是为了让子进程去完成不同于父进程的某项任务,因此含有fork的程序,通常的编程模板如下:
if ((pid = fork()) == 0) {
       dosomething in child process;
       exit(0);
}
do something in parent process;
这样的编程模板使得父、子进程各自执行同一个二进制文件中的不同代码段,完成不同的任务。这样的编程模板在大多数情况下都能胜任,但仔细观察这种编程模板,你会发现它要求程序员在编写源代码的时候,就要预先知道子进程要完成的任务是什么。这本不是什么过分的要求,但在某些情况下,这样的前提要求却得不到满足,最典型的例子就是Linux的基础应用程序 —— shell。你想一想,在编写shell的源代码期间,程序员是不可能知道当shell运行时,用户输入的命令是ls还是cp,难道你要在shell的源代码中使用if--elseif--else if--else if ……结构,并拷贝 ls、cp等等外部命令的源代码到shell源代码中吗?退一万步讲,即使这种弱智的处理方式被接受的话,你仍然会遇到无法解决的难题。想一想,如果用户自己编写了一个源程序,并将其编译为二进制程序test,然后再在shell命令提示符下输入./test,对于采用前述弱智方法编写的shell,它将情何以堪? 因此需要exec予以协作。
exec机制
在用fork函数创建子进程后,子进程往往要调用exec函数以执行另一个程序。 当子进程调用exec函数时,会将一个二进制可执行程序的全路径名作为参数传给exec,exec会用新程序代换子进程原来全部进程空间的内容,而新程序则从其main函数开始执行,这样子进程要完成的任务就变成了新程序要完成的任务了。 因为调用exec并不创建新进程,所以前后的进程ID并未改变。exec只是用另一个新程序替换了当前进程的正文、数据、堆和栈段。进程还是那个进程,但实质内容已经完全改变。呵呵,这是不是和中国A股的借壳上市有异曲同工之妙? 顺便说一下,新程序的bss段清0这个操作,以及命令行参数和环境变量的指定,也是由exec完成的。
exec用法
函数原型:
int execle(const char * pathname,const char * arg0, ... (char *)0, char * const envp [] )返回值: exec执行失败返回-1,成功将永不返回(想想为什么?)。哎,牛人就是有脾气,天字1号是调用1次,返回2次;地字1号,干脆就不返回了,你能奈我何? 参数:pathname:新程序的二进制文件的全路径名arg0:新程序的第1个命令行参数argv[0],之后是新程序的第2、3、4……个命令行参数,以(char*)0表示命令行参数的结束envp:新程序的环境变量
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
int main(int argc, char*argv[])
{
       int  i;
       char **ptr;
       extern char  **environ;
        for (i = 0; i < argc; i++)   /* echo all command-line args */
            printf("argv[%d]:%s\n", i, argv[i]);
        for (ptr = environ; *ptr != 0;ptr++)  /* and all env strings */
            printf("%s\n",*ptr);
}
将此程序进行编译,生成二进制文件命名为echoall,放在当前目录下。很容易看出,此程序运行将打印进程的所有命令行参数和环境变量。 运行结果分析:
1-5行是第1个子进程14行运行新程序echoall的结果,其中:1-3行打印的是命令行参数;4、5行打印的是环境变量。 6行之后是第2个子进程23行运行新程序echoall的结果,其中:6、7行打印的是命令行参数;8行之后打印的是环境变量。之所以第2个子进程的环境变量那么多,是因为程序23行调用execlp时,没有给出环境变量参数,因此子进程就会继承父进程的全部环境变量。
进程的消亡
gdb调试多进程技巧
对多进程程序进行调试,存在一个较大的难题,那就是当程序调用fork产生子进程后,gdb跟踪的是父进程,无法进入到子进程里去单步调试子进程。这样一来,如果子进程中的代码运行出错的话,将无法进行调试。 因此想调试子进程的话,需要一点技巧:
在子进程的入口处加入sleep(20)函数,以使子进程在被创建后能暂时停止。 用ps查看子进程的pid,假定pid为222,则输入命令:gdb程序名称222。从而再运行一个调试程序,使得gdb attach到子进程。 用gdb的break命令在子进程中设定断点。 用gdb的continue,恢复子进程的运行。 等待sleep的睡眠时间到达,从而子进程将在断点处停下来。
启动例程与main函数
从程序员的角度看,C应用程序从main函数开始运行。但事实上,当C应用程序被内核通过exec启动时,一个启动例程会先于main函数运行,它会为main函数的运行准备好环境后,调用main函数。而main函数正常结束后return语句将使得main函数返回到启动例程,启动例程在完成必要的善后处理后将最终调用_exit结束进程。 有5种方式结束进程:
正常结束:
1.从main函数返回 2.调用exit 3.调用_exit
非正常结束:
4.调用abort 5.被信号中止
exit函数与_exit函数
需要包含的头文件:<stdlib.h>、<unistd.h> 函数原型:
void exit(int status)、 void _exit(int status)这两个函数的功能都是使进程正常结束。_exit:立即返回内核,它是一个系统调用exit:在返回内核前会执行一些清理操作,这些清理操作包括调用exit handler,以及彻底关闭标准I/O流(这回使得I/O流的buffer中的数据被刷新,即被提交给内核),它是标准C库中的一个函数。
I/O流和I/O库缓存
关于IO流的buffer:
#include <stdio.h>
#include <unistd.h>
int main(void)
{
    printf("hello");
    //printf("hello\n");
    //write(1, "hello", 5);
    sleep(100);
    return 0;
 }
其结果没有任何输出。
当应用程序调用printf时,将字符串"hello"提交给了标准I/O库的I/O库缓存。I/O库缓存大致可以认为是printf实现中定义的全局字符数组,因此它位于用户空间,可见"hello"并没有被提交给内核(所以也不可能出现内核将"hello"打印到屏幕的操作),所以没有打印出任何东西。只有当某些条件满足时,标准I/O库才会刷新I/O库缓存,这些条件包括:
用户空间的I/O库缓存已被填满 I/O库缓存遇到了换行符(‘\n’),并且输出目标是行缓冲设备(屏幕就是这种设备)。因此将上面的代码第6行注释掉,并取消第7行的注释,就可以看到打印出了hello I/O流被关闭,上节中的exit函数就会关闭I/O流 Tips: 当标准I/O库缓存时,会调用以前的我们学过的系统调用,例如:write,将I/O库缓存中的内容提交给内核。 so,上述代码也可以这样:第6行注释,第7行注释,第8行取消注释。也可以在屏幕上看见"hello"
Exit handler
Exit handler 是程序员编写的函数,进程正常结束时,它们会被系统调回。这使程序员具备了在进程正常结束时,控制进程执行某些善后操作的能力。 使用Exit handler,需要程序员完成两件事情:编写Exit handler函数;调用atexit或on_exit向系统注册Exit handler(即告知系统需要回调的Exit handler函数是谁) 需要包含头的文件:<stdlib.h> 函数原型:
int atexit(void (* func)(void))
int on_exit(void (* func)(int, void *),)
功能: atexit注册的函数func没有参数;on_exit注册的函数func有一个int型参数,系统调用回调func时将向该参数传入进程的退出值,func的另一个void *类型参数将会是arg。 ANSI C中,进程最多可以注册32个Exit handler函数,这些函数按照注册时的顺序被逆序调用。
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
static void my_exit0(int, void *);
static void my_exit1(void);
static void my_exit2(void);
char str[9]="for test";
int main(void) {
        //char str[9]="for test";
    if (atexit(my_exit2) != 0) {
        perror("can't register my_exit2");
        exit(-1);
    }
    if (atexit(my_exit1) != 0) {
        perror("can't register my_exit1");
        exit(-1);
    }
    if (on_exit(my_exit0,(void *)str) !=0) {
        perror("can't register my_exit0");
        exit(-1);
    }
    printf("main is done\n");
    printf("abc");
    //_exit(1234);
    exit(1234);
}

static void my_exit0(int status, void *arg) {
    printf("zero exit handler\n");
    printf("exit %d\n", status);
    printf("arg=%s\n",(char *)arg);
}

static void my_exit1(void) {
    printf("first exit handler\n");
}
static void my_exit2(void)  {
    printf("second exit handler\n");
}
进程中止处理函数执行顺序按照设置顺序的相反顺序执行。